

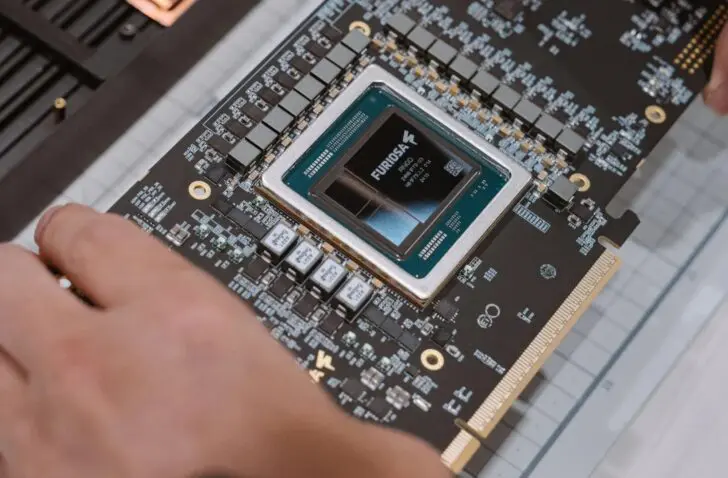
FuriosaAI gaat in zee met Broadcom voor de ontwikkeling van een AI-accelerator van de derde generatie. De nieuwe chip krijgt een chiplet-architectuur met een 2 nm-rekencomponent, HBM4/4E-geheugen en netwerktechnologie van Broadcom.
FuriosaAI kondigt een nieuwe AI-accelerator aan in samenwerking met Broadcom. Het gaat om de derde generatie van AI-chip voor het bedrijf. De nieuwe accelerator bouwt voort op de bestaande architectuur, maar ontpopt zich tot een design op basis van chiplets. FuriosaAI mikt op grote AI-clusters bij hyperscalers.
Belangrijke rol voor Broadcom
Broadcom speelt daardoor een grote rol. Het bedrijf levert niet alleen packaging, maar ook Ethernet-, PCIe- en switchtechnologie.
FuriosaAI combineert een 2 nm-compute-chiplet met HBM4/4E in één system-on-chip(SoC). Broadcom moet die verschillende onderdelen met zijn packaging-technologie samenbrengen in één platform gebouwd voor inferentie.
De chip volgt twee eerdere generaties van accelerators op. De eerste chip was nog geoptimaliseerd voor computervisie. Generatie twee kreeg de naam RNGD, en werd al in de markt gezet voor AI-inferentie voor enterprise-klanten.
Inferentiemachine
FuriosaAI wil met de nieuwe accelerator opnieuw een inferentiemachine bouwen op maat van hoge tokenvolumes in grote AI-omgevingen. Daarbij hoort meer dan rekenkracht alleen: efficiënte databeweging tussen servers en racks zijn eveneens belangrijk. Beide bedrijven willen AI-clusters naar duizenden nodes schalen. De infrastructuur moet zorgen voor snelle communicatie binnen grote inferentieclusters.
De chip is geoptimaliseerd voor praktijkgerichte AI-workloads, waaronder intensieve post-training sampling. FuriosaAI zegt dat de aanpak met focus op databeweging efficiënter is dan de thread-aanpak van gpu’s, met meer prestaties per watt en een hogere tokendichtheid als doel.