

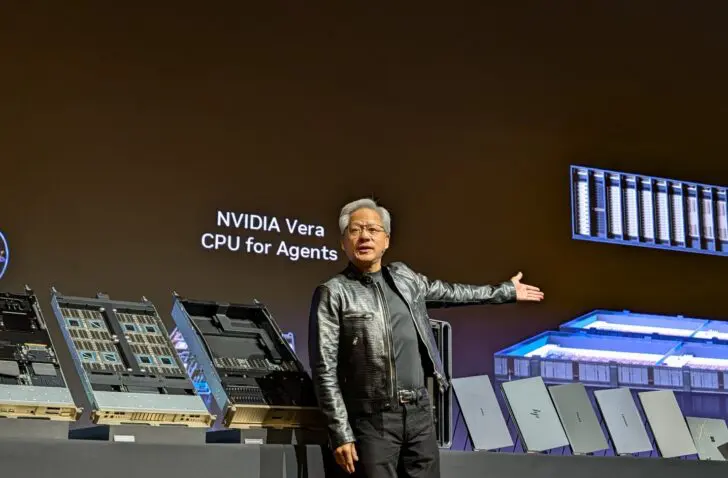
Een van de beste manieren om het geheugengebruik te verbeteren, is werken met extreem lage precisie. Dat klinkt negatief, maar dat hoeft het niet te zijn volgens de CEO van Nvidia.
Tijdens een persmoment op Computex legt Nvidia CEO Jensen Huang uit hoe de chipmaker het wereldwijde geheugentekort wil counteren. Hij wil meer doen met minder om zo het geheugengebruik dramatisch te minderen.
“De sleutel is NVFP4, een 4-bit-formaat dat het aantal parameters in dezelfde geheugenruimte verdubbelt, aangevuld met AI-technieken zoals neural rendering en neural texture compression.”
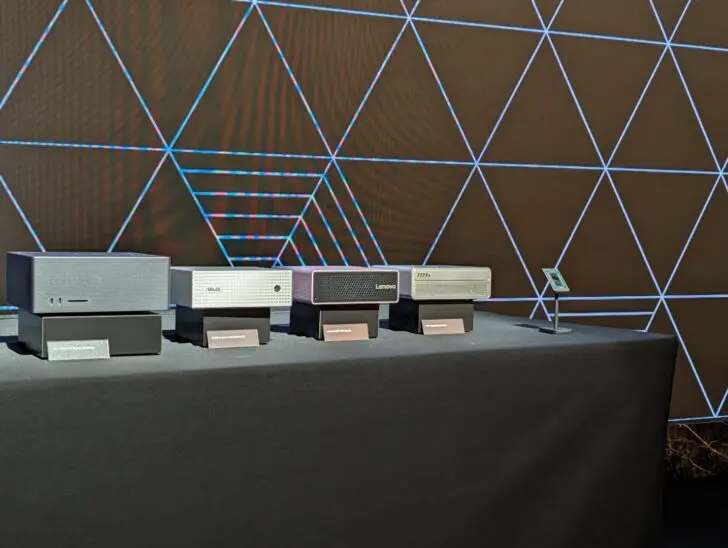
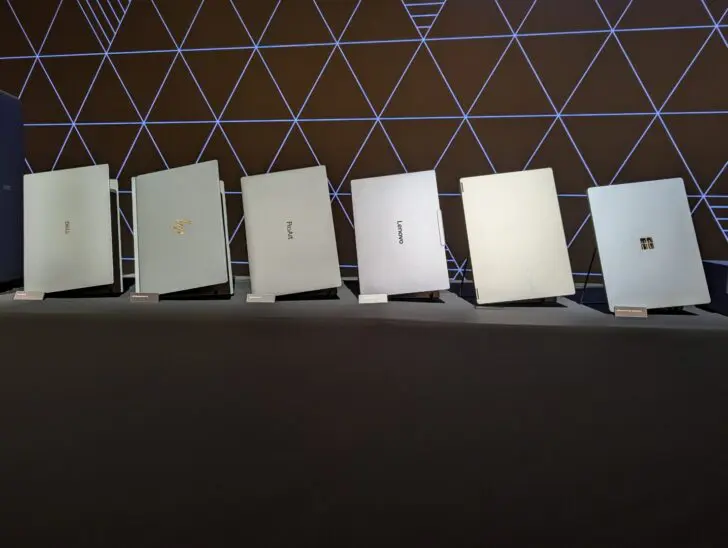
RTX Spark-computer
“Een van de beste manieren om het geheugengebruik te verbeteren, is werken met extreem lage precisie”, klinkt het. “In plaats van waarden in 8 of 16 bit op te slaan, comprimeren we ze tot vier bit. Hierdoor past eenzelfde model in de helft of een vierde van de ruimte.”
Die filosofie is niet nieuw, maar Nvidia trekt ze nu door tot in de consumenten- en zakelijke pc. RTX Spark, de Windows-chip die Nvidia samen met MediaTek bouwde, leunt zwaar op precisiereductie via zogenaamde Tensor Cores om lokale AI-agenten te kunnen draaien zonder dat het geheugen volloopt.
Wat NVFP4 anders maakt
NVFP4 is Nvidia’s eigen 4 bit floating point-formaat, geïntroduceerd met de Blackwell-architectuur. Elk getal wordt opgeslagen in de E2M1-structuur: één tekenbit, twee exponentbits en één mantissebit. Daardoor kan een enkele waarde slechts een handvol niveaus aannemen. Denk daarbij aan de reeks 0, 0,5, 1, 1,5, 2, 3, 4 en 6, zowel positief als negatief, in een bereik van ongeveer -6 tot 6.
Op zich is dat veel te grof voor neurale netwerken. Nvidia lost dat op met een tweetrapssysteem van schaalfactoren. Per micro-blok van zestien waarden geldt een fijnmazige FP8-schaalfactor (E4M3), en daarbovenop ligt nog een globale FP32-schaalfactor voor de hele tensor.
Concurrentie met MXFP4
Net die kleinere blokgrootte vormt het verschil met het concurrerende MXFP4, dat blokken van 32 waarden hanteert: door te halveren tot zestien waarden krijgt NVFP4 dubbel zoveel ijkpunten en blijft de kwantisatiefout beperkt.
“NVFP4 is niet zomaar 4-bit floating point, het is een volledige tensorstructuur, een hele wiskundige structuur die kan rekenen op een precisie van slechts vier bit, maar die dynamisch schakelt tussen 4, 8, 16 en zelfs 32 bit wanneer dat nodig is”, zegt Huang. Hij benadrukt wel dat vier bit zoveel mogelijk gebruikt.
“De vijfde generatie Tensor Cores in Blackwell verwerkt dat formaat hardwarematig, inclusief de groepering van elementen en de dynamische schaling.” Volgens Nvidia levert dat tot zesmaal hogere doorvoer en een halvering van het geheugengebruik op tegenover FP8, terwijl de nauwkeurigheid dicht bij die van FP16 blijft.
Schaars geheugen
De concrete winst voor RTX Spark vatte Huang in één cijfer: “Daardoor kunnen we het neurale netwerk dat we in het geheugen plaatsen comprimeren, en zo het aantal parameters in amper 128 gigabyte verdubbelen.” Met andere woorden, een model dat normaal niet lokaal zou passen, draait nu wél op het toestel zelf.
Dat is geen detail, maar de kern van de strategie van Nvidia. Lokale AI-agenten hebben veel parameters nodig om bruikbaar te zijn, en geheugen is net de schaarse, dure component. Door de geheugenvoetafdruk te halveren, maakt Nvidia AI-agenten haalbaar op een pc in plaats van uitsluitend in het datacenter. Die timing is niet toevallig wanneer de prijzen voor geheugen wereldwijd onder druk staan.
Waar de markt vooral kijkt naar de beschikbaarheid van HBM- en DRAM-capaciteit, kiest Nvidia er bewust voor om het probleem deels in software en formaten op te lossen. NVFP4 verschuift de last van ‘meer geheugen kopen’ naar ‘slimmer met geheugen omgaan’. Voor een platform als RTX Spark, dat altijd-aan, lokale AI-agenten belooft, is dat misschien wel de doorslaggevende troef.